Если вы включите сейчас любой IT-подкаст, то заметите одну интересную деталь: мы почти перестали обсуждать фреймворки, базы данных или изменения в языках программирования. Сейчас все переключились на обсуждение свежих моделей, автономных агентов и вайбкодинга. Можно долго спорить о том, хайп это или не хайп, но факт остаётся фактом: нейросети дают огромные возможности. Люди без навыков написания кода могут создавать работающие продукты и менять жизнь вокруг себя.
Недавно я выступал перед студентами в школе разработки интерфейсов от Яндекса. Для меня это было особенным моментом: 4 года назад я, как и они, грыз гранит науки, учился современным практикам разработки. С тех пор прошло много времени, но каждый год я возвращался в школы, чтобы менторить студентов, передавать им свои знания.
В этом году мне выпала честь читать лекцию про использование AI инструментов: от основ до продвинутого уровня, делясь лучшими практиками, которые выработались у нас в Яндексе. Основной темой моего доклада стало то, как я активно делегирую рабочие задачи нейросетям. Они генерируют понятные сообщения для коммитов и помогают нашим тестировщикам анализировать падения автотестов. А для себя лично я собрал бота, который ищет дешёвые авиабилеты и показывает красивых котиков.
Сегодня навык работы с AI становится новой грамотностью — это уже такая же база, как умение пользоваться компьютером.
Но чтобы нейросети действительно помогали решать задачи, а не только изображали бурную деятельность, с ними нужно уметь грамотно работать. Обычные one-shot запросы могут сработать на простых задачах или в небольших личных проектах, но, как правило, в больших коммерческих проектах требуется применять большую изобретательность и большее количество инструментов и приёмов, чтобы выжать из нейросети максимум: решить задачу, написать корректный код.
Почему просто промптинг больше не работает
Представьте обычную задачу на рабочем проекте: нужно добавить новый экран. Раньше единственным вариантом было сесть и верстать всё руками. Это долго и скучно, и всегда есть вероятность допустить опечатку и потом долго отлавливать её в коде. Теперь у нас есть опция: скинуть макет нейросети, а самому пойти пить кофе или начать решать следующую задачу.
Давайте проверим, как средняя модель справится с этой задачей. Возьмём скриншот страницы нашей внутренней биржи проектов, загрузим в модель (для примера возьмём Haiku 4.5) и напишем простой промпт:
Вот скриншот главной страницы. Используй его для того, чтобы сверстать главную. Make no mistakes
А теперь смотрим на результат. Издалека вроде бы похоже, но при приближении без слёз не взглянешь: компоненты не те, вёрстка откровенно кривая, итоговый интерфейс далёк от оригинального макета.
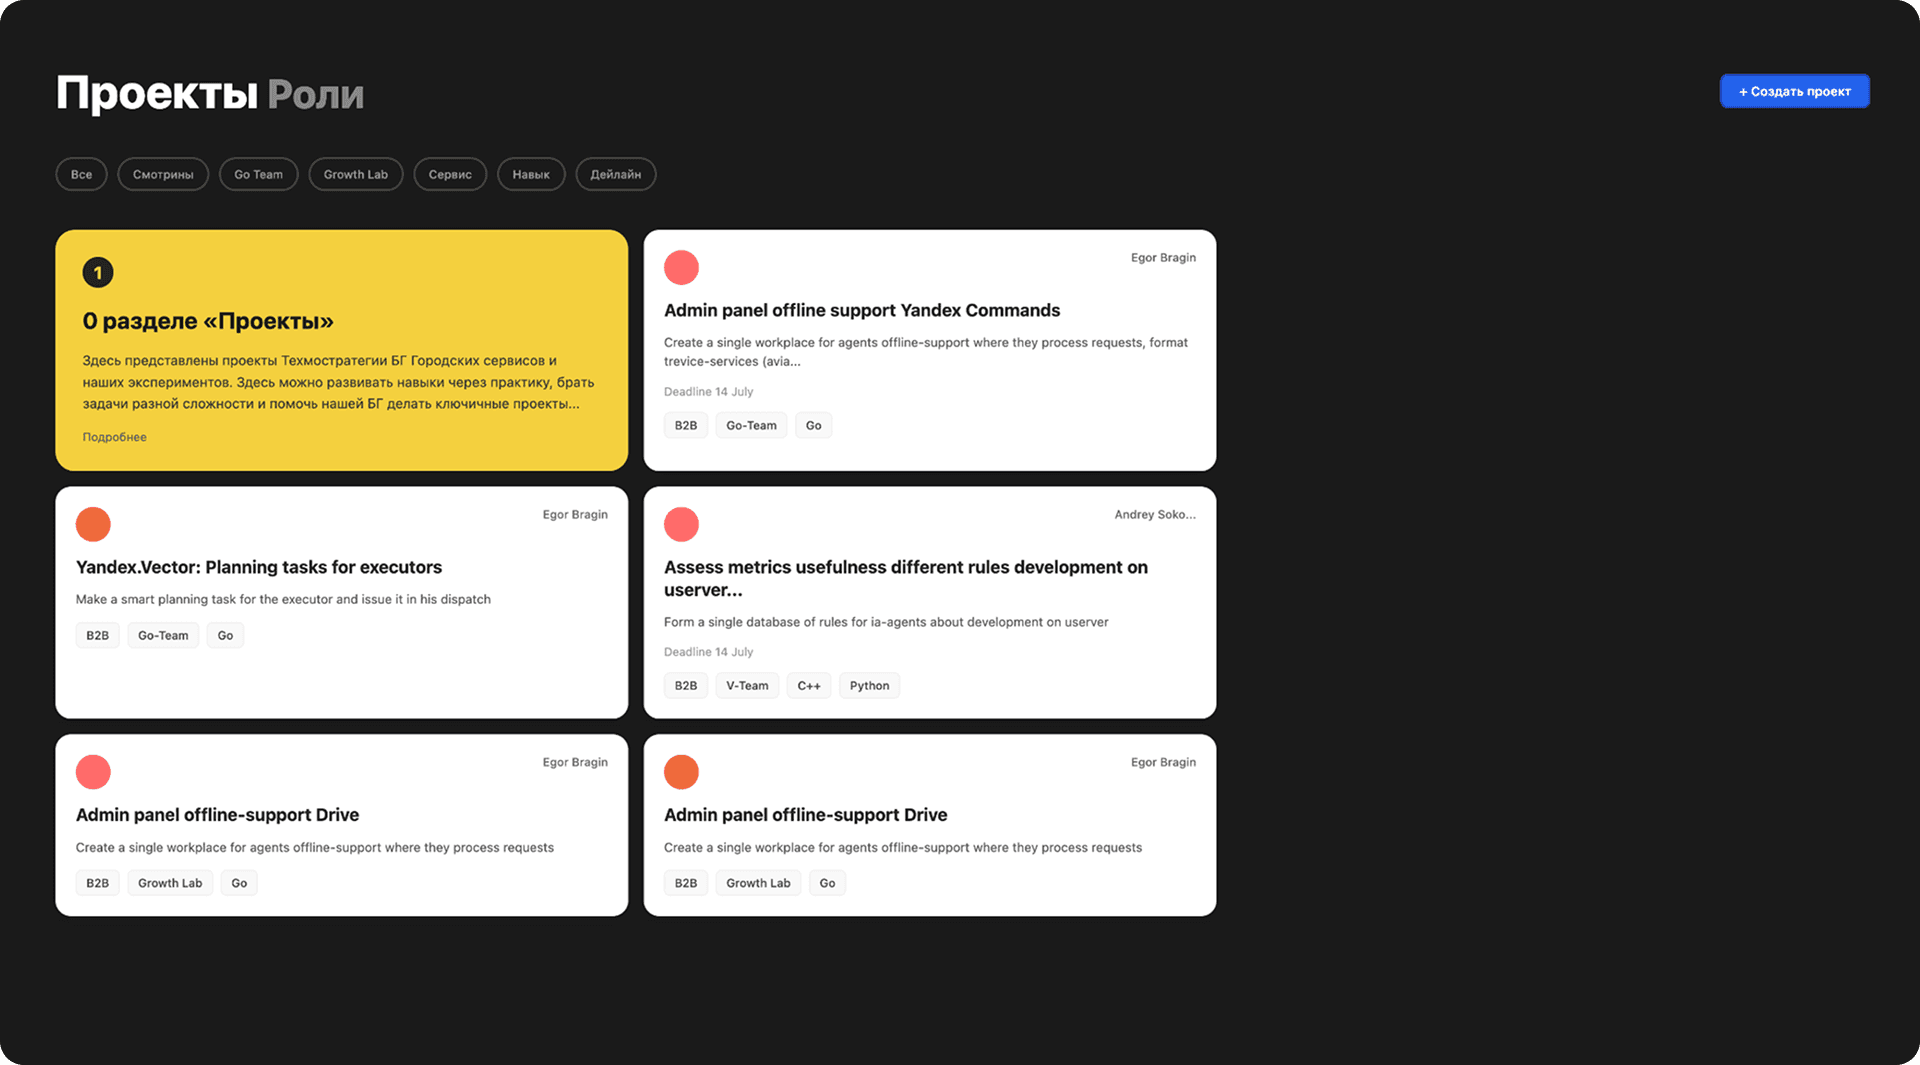
Очевидно, что такой подход в лоб не работает, особенно на слабых моделях или на проектах, без настроенного для AI окружения. Нельзя просто сказать «сделай хорошо» и надеяться, что нейросеть действительно сделает хорошо и напишет production-ready код. Для этого модели нужны чёткие инструкции и правильный язык общения.
Естественный язык или Markdown
Форматов написания запросов много, но глобально они делятся на два типа: естественный язык и Markdown.
Естественный язык удобен, когда задача простая и короткая. Вы просто просите нейросеть о чём-то, как попросили бы коллегу. Но когда задача усложняется, когда мы добавляем детали, ограничения и специфику проекта, такой текст становится тяжело читать и разбирать даже самой модели.
Поэтому в сложной разработке стандартом стал Markdown. Он даёт тексту строгую структуру, возможность разбивать его на блоки и позволяет нейросети однозначно считывать ваши требования, минимизируя риск ошибок и неверных интерпретаций.
Простая математика: почему английский язык выгоднее
Следующий неочевидный фактор — выбор языка общения. Многие из нас отлично формулируют мысли на русском. И для разовых задач это абсолютно нормально. Но если ваш запрос будет использоваться многократно или встроен в скрипт автоматизации, лучше перейти на английский. И дело тут совсем не в том, что модель «плохо понимает» по-русски.
Дело в токенах — минимальных единицах обработки текста в моделях машинного обучения. Токенайзер разбивает текст на части. Чем чаще слово встречалось в обучающей выборке, тем выше шанс, что оно будет закодировано одним токеном. Плюс кириллица и иероглифы банально занимают больше байтов на символ. Мой коллега, большой учёный и сотрудник Яндекса Юрий Зеленков, провёл точные расчёты, и вот какая интересная картина у него получилась:
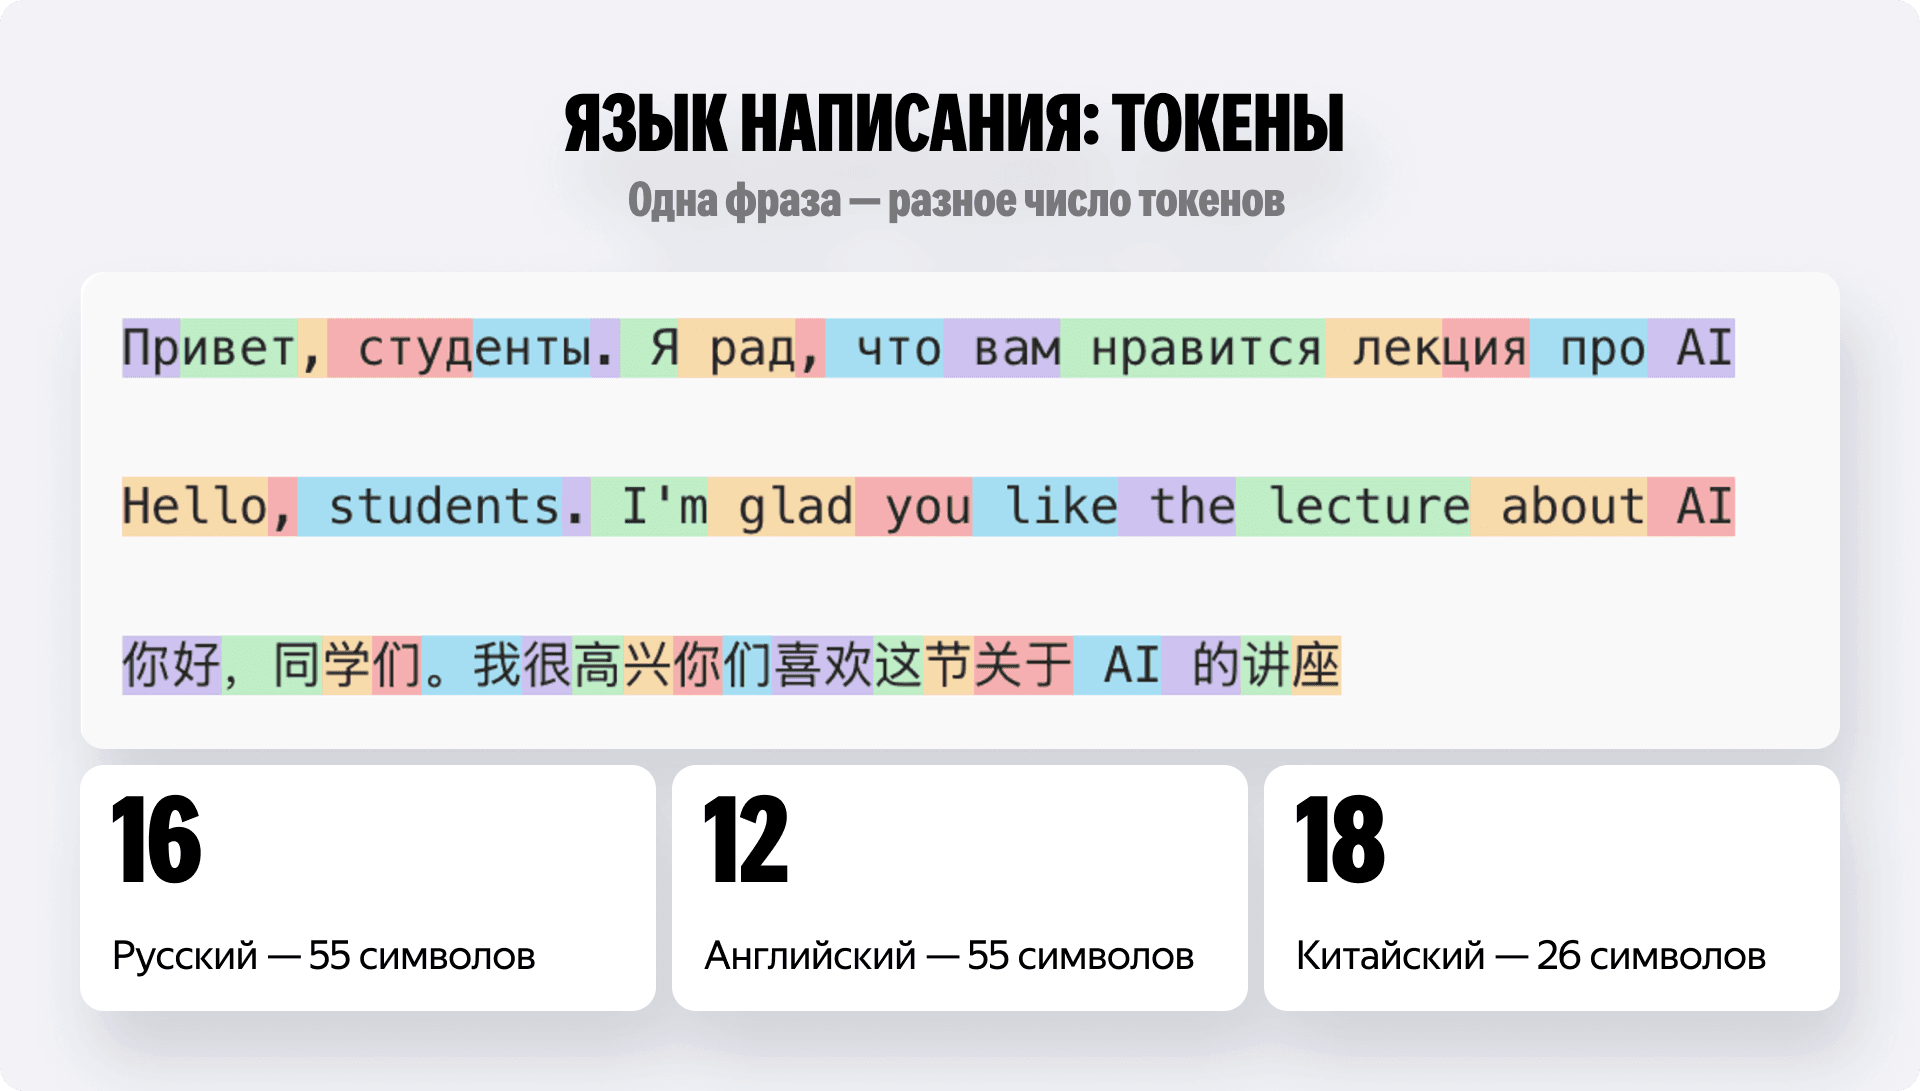
Расчёты показывают интересную картину:
- русский язык: 1 слово ≈ 2.5 токена;
- английский язык: 1 слово ≈ 1.5 токена;
- китайский язык: 1 иероглиф ≈ 0.6 токена.
Здесь стоит сделать важный дисклеймер: токенайзеры бывают разными. У разных провайдеров и даже у разных моделей они могут отличаться. В нашем примере расчёты опираются на токенайзер OpenAI.
Но общая тенденция сохраняется: просто перейдя на английский язык, вы можете сэкономить до 40% в потреблении токенов. Вы получите ответ быстрее, потратите меньше лимитов и сэкономите место в контекстном окне для действительно важной информации — например, для вашего кода.
Структура хорошего запроса
Вокруг общения с нейросетями выросло много мифов про некие секретные слова и хитрые скрытые формулировки, которые могут заставить модель писать идеальный код. Но на деле всё решают инженерия и структура.
Вместо поиска тайных комбинаций достаточно придерживаться универсального шаблона. Как правило, хороший промпт состоит из следующих блоков:
- контекст — окружение для модели (например: «TypeScript 5.x, без внешних библиотек, нативный тест-фреймворк»);
- задача — что именно нужно сделать;
- ограничения — явные запреты (например: «чистая функция без побочных эффектов»);
- примеры — как входные данные должны превращаться в выходные (техники zero, one или few-shot);
- формат ответа — как вы хотите получить решение (например: «верни только код: сначала функцию, затем блок тестов»).
Если вам сложно составить такой запрос с нуля, используйте метапромптинг. Это подход, при котором вы поручаете создание запроса самой модели, ведь она отлично знает, как устроены хорошие инструкции. Вы просто просите её задать вам наводящие вопросы и затем собрать финальный текст.
Например, если вы фронтендер и вам нужно изучить чужой бэкенд, то вместо того, чтобы мучиться с формулировками, вы можете отправить модели что-то вроде:
«Помоги составить промпт. Мне нужно разобраться в незнакомом бэкенде: какие есть эндпоинты, в каком формате приходят ответы, как устроена авторизация. Сначала задай мне уточняющие вопросы (какой у нас стек, есть ли доступ к коду и документации, что именно я хочу понять), а потом собери финальный промпт для моего исследования».
Учим нейросеть видеть проект и работать руками
Но даже если вы напишете идеальный структурированный запрос на чистом английском, остаётся одна фундаментальная проблема. Бот живёт в браузере, а ваш код — в локальной файловой системе. Переносить контекст руками туда и обратно долго и крайне неудобно. Поэтому нам понадобился совершенно другой класс инструментов.
Для того, чтобы не копировать код из редактора в браузерный чат и обратно появились Cursor, Zed и расширения для привычных IDE вроде нашего яндексового Code Assistant. У них есть доступ к проекту и его файлам, они видят всю структуру и могут с ней взаимодействовать по мере набора кода.
Но настоящая автономность начинается тогда, когда нейросеть подключается к терминалу. Это как бесконечное количество роботов, помогающих вам работать над проектом в изолированных средах. Вы ставите задачу, а они сами читают файлы, запускают команды, правят код, гоняют тесты и итеративно идут к результату. Это CLI-агенты: популярный Claude Code, опенсорсный OpenCode или минималистичный PI.
Даём модели руки
Сама по себе языковая модель умеет только одно: получать текст и отдавать текст. Она не может прочитать файл на вашем диске, запустить сборку или сходить в интернет. Чтобы нейросеть начала взаимодействовать с внешним миром, придумали программную обвязку — harness, и инструменты — tools.
По смыслу инструмент — это простая системная инструкция, которая загружается в модель в начале сессии. В ней буквально сказано:
Когда ты хочешь прочитать файл — сгенерируй текст read_file("path/to/file")
или
Когда ты хочешь запустить команду — сгенерируй текст bash("some command")
Соответственно, модель генерирует и отдаёт этот текст. Дальше обвязка перехватывает его, реально вызывает нужный инструмент (идёт на диск или в терминал) и возвращает результат обратно в модель. Цикл замыкается.
В реальных репозиториях агентов доступные инструменты и их ограничения описываются строгими конфигурационными файлами. Вот пример такого блока кода, который наглядно показывает всю суть работы с инструментами:
name: my-skill
description: What this skill does and when to use it
allowed-tools: Read, Grep, Glob           # разрешённые инструменты
disallowed-tools: Write, Edit             # явно запрещённые инструменты
shell: bash                               # оболочка для выполнения команд
hooks:                                    # хуки для перехвата действий
  PreToolUse:
    - matcher: "Bash"
      hooks:
        - type: command
          command: "./scripts/validate.sh"
Когда мы говорим «ИИ-агент», мы подразумеваем не просто умную языковую модель, а именно эту чёткую связку: модель, программная обвязка и вот такой жёстко сконфигурированный набор инструментов.
Гигиена кода
Но если дать нейросети полный бесконтрольный доступ к терминалу, она может случайно снести базу данных или наделать других глупостей. Чтобы агент не разрушил проект, нам нужны предохранители — хуки (hooks).
Механика очень похожа на обычные git-хуки. Вы можете прямо в конфиге запретить агенту читать файлы с секретами или выполнять опасные операции. А ещё хуки отлично подходят для поддержания чистоты кода. После каждой правки они автоматически запускают линтеры и автоформат (например, Prettier), чтобы код оставался в едином стиле. Также они умеют пересобирать AST-индекс проекта: так агент всегда знает актуальную структуру кода, быстро находит нужные символы и не тратит лишние токены на долгий поиск.
Динамические знания без каши в голове
Окей, агент умеет читать файлы и безопасно писать код. Но он ничего не знает про специфику именно вашего продукта. Вы, конечно, можете вывалить всю документацию в стартовый запрос, но тогда контекстное окно быстро закончится. К тому же модель начнёт путаться в лишней информации и терять фокус — это называется context rotting.
Чтобы этого избежать, можно использовать скиллы (skills). Это текстовые инструкции, которые агент подгружает строго по требованию.
Например, у вас есть скилл по работе с дизайн-системой. Пока агент пишет бэкенд, он про этот документ даже не вспоминает. Но как только вы просите добавить новую кнопку на фронтенде, он подхватывает нужный скилл, читает правила работы с локальной UI-библиотекой и генерирует правильный код. Скиллы экономят контекст и помогают модели оставаться сфокусированной.
Даём агенту ещё и глаза
Вернёмся к нашей задаче, которую описывали выше. Мы просили ИИ сверстать экран по картинке, и он выдал кривой результат. Скилл про дизайн-систему поможет использовать правильные компоненты, но агент всё равно будет работать вслепую: он просто угадывает отступы и цвета по скриншоту.
Было бы логично дать агенту прямой доступ к макетам и инструментам. И здесь на сцену выходит MCP (Model Context Protocol). Если упрощать, то это стандартизированная коробка с внешними тулами. Сегодня почти любой крупный сервис предоставляет свои MCP-серверы.
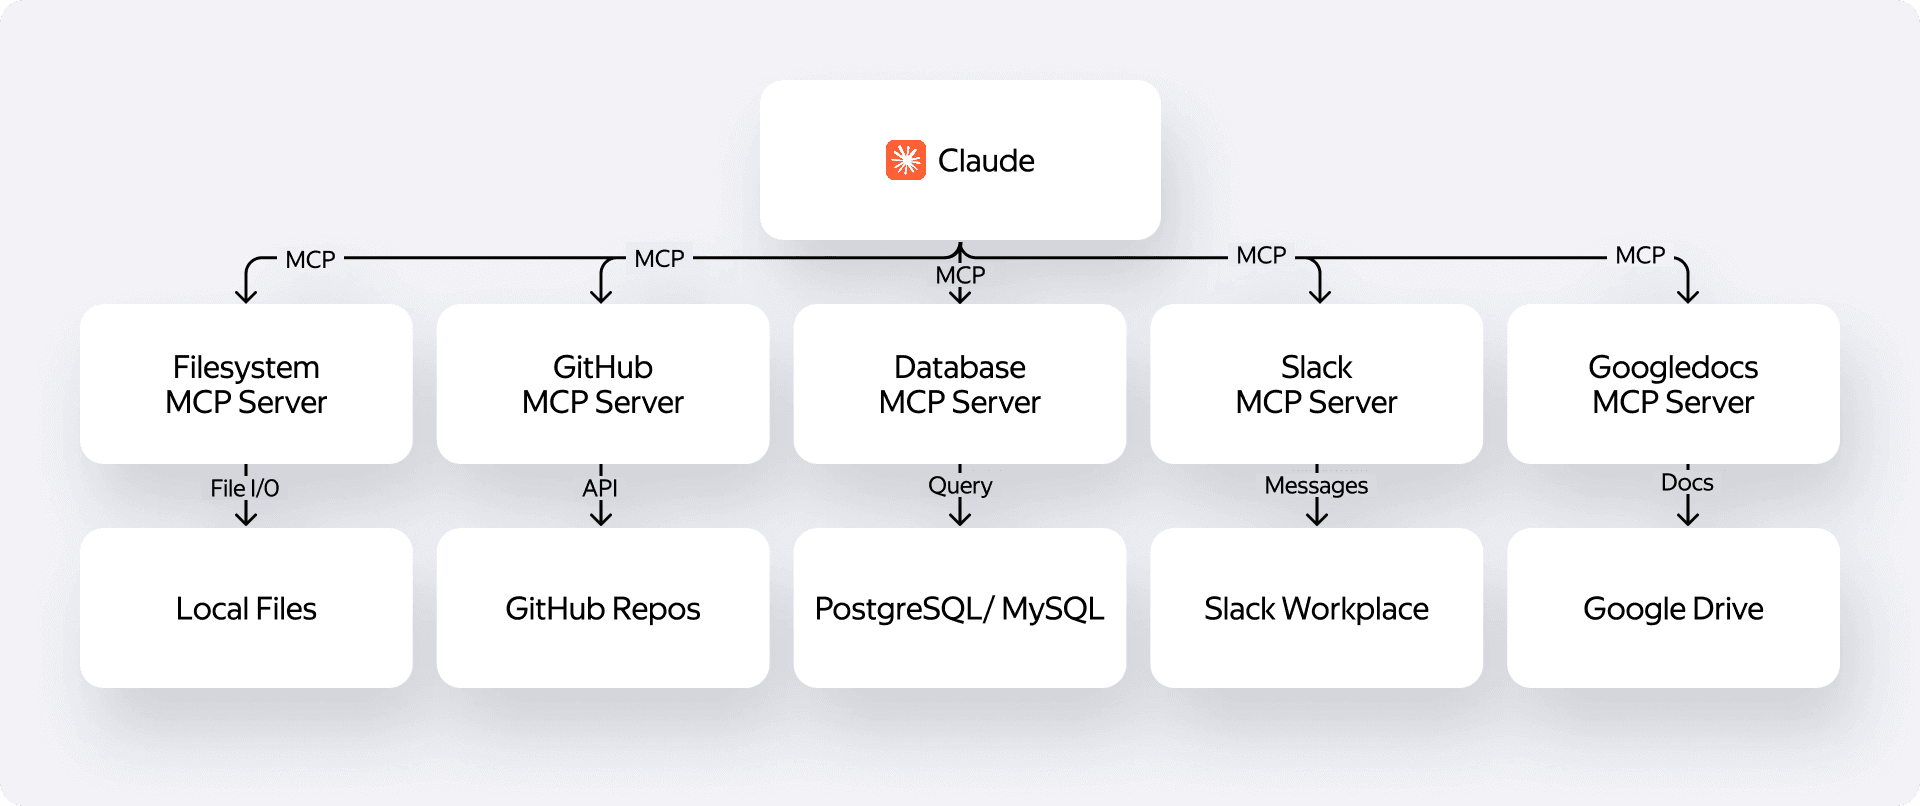
Для нашего фронтенд-проекта мы подключаем сразу две полезные сущности:
-
Figma MCP — теперь агент сам ходит в дизайн. Он берёт точные размеры, hex-коды цветов, правильные названия компонентов и все их скрытые состояния.
-
Playwright MCP — даёт агенту настоящий браузер. Он может сам открыть собранную страницу, покликать по кнопкам, заполнить форму и «своими глазами» убедиться, что всё работает.
Собираем автономного коллегу
Мы дали агенту инструменты, знания проекта и даже «глаза». Но для полноценной работы этого всё ещё мало. Да, у современных моделей огромное контекстное окно, но даже оно не бесконечное. А если ещё и загрузить в память десятки файлов исходного кода, нейросеть начнёт путаться, отвлекаться на нерелевантные строки и забывать важные детали. Чтобы этого не происходило, мы применяем ещё один архитектурный подход.
Простое делегирование рутины
Основной агент выполняет роль дирижёра. Когда он сталкивается с объёмной задачей, он не делает её сам, а нанимает субагента — отдельную сущность со своим изолированным контекстом и циклом работы.
Возьмём типичный пример: вы просите добавить новое поле в ответ API. Прежде чем писать код, агенту нужно понять, где этот ответ собирается, где лежат типы и как устроена валидация. Для этого ему как минимум придётся прочитать пару десятков файлов. И если он сделает это в основной сессии, то забьёт память лишней информацией.
Вместо этого он отправляет запрос субагенту-исследователю: «найди, где собирается и валидируется этот ответ». Субагент роется в репозитории, переваривает кучу файлов и возвращает наружу только короткую выжимку: вот четыре нужных файла и паттерн сборки. Основная сессия при этом остаётся чистой и сфокусированной.
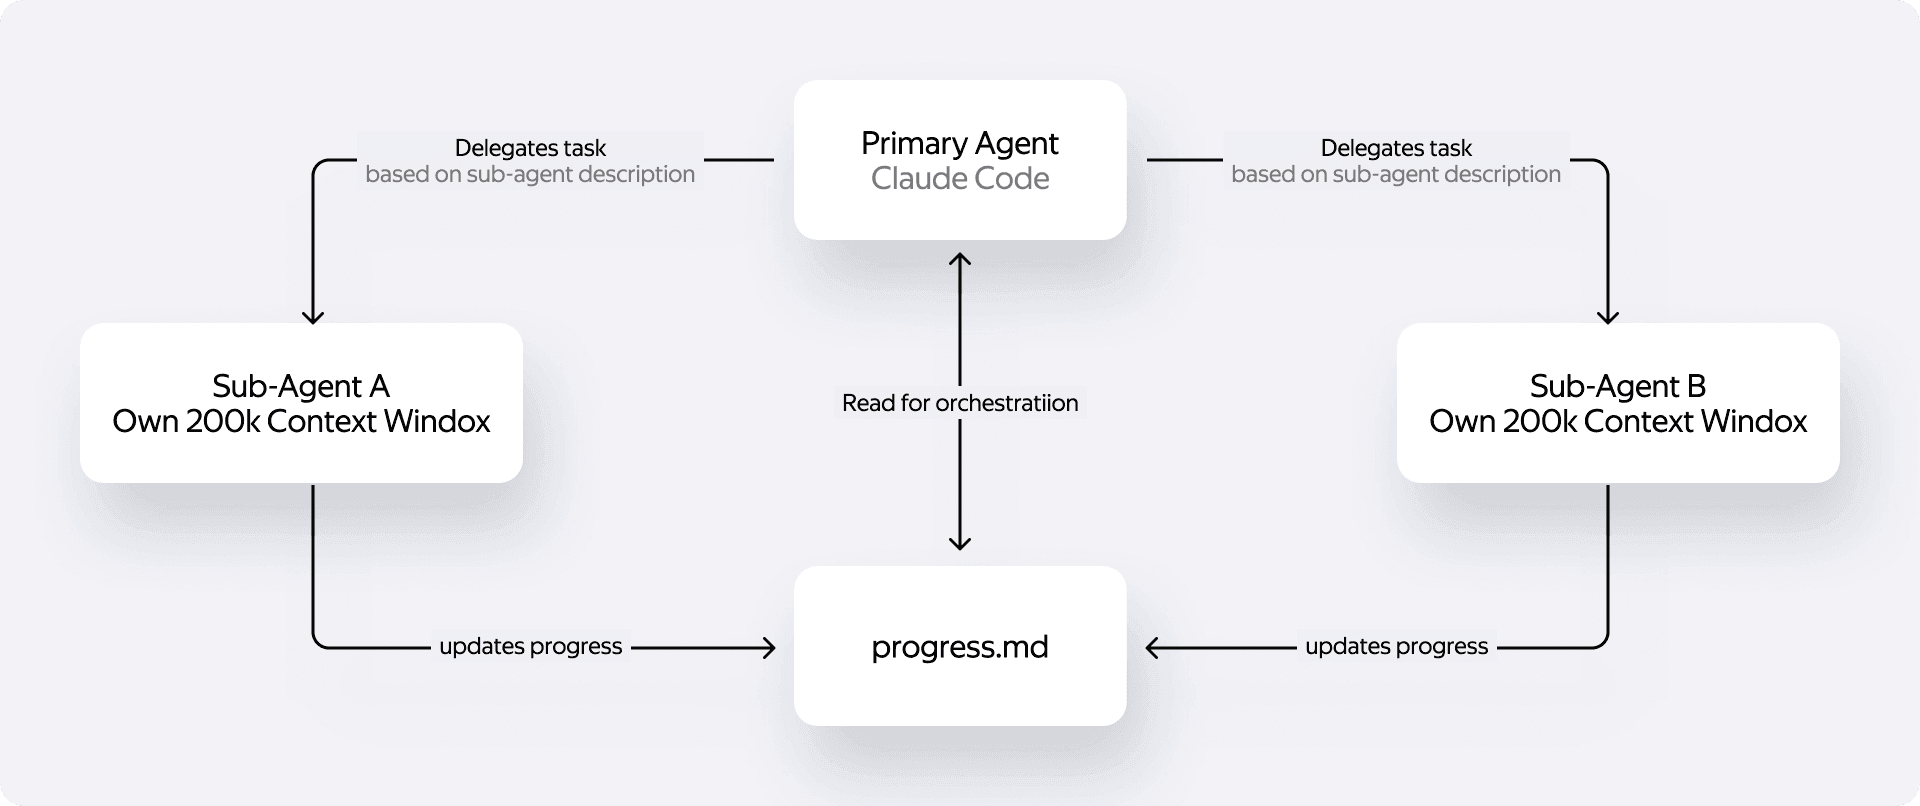
По такому же принципу работает субагент-тестировщик. Тот, кто писал код, всегда склонен верить, что всё работает идеально. Поэтому проверку логичнее отдать отдельному субагенту. Как минимум потому что свежий взгляд без предвзятости сможет найти больше багов. Главная идея здесь — изоляция: мы выносим тяжёлую работу в сторону, а на выходе получаем готовый и чистый результат.
Собираем автономный пайплайн
Все эти инструменты по отдельности — документация, скиллы, MCP, хуки и субагенты — работают отлично. Но запускать их локально в терминале — это всё ещё ручной труд. В идеальном мире хочется поставить задачу и уйти заниматься своими делами, пока робот пишет код.
Давайте посмотрим, как можно объединить эти разрозненные концепции и построить полноценного виртуального сотрудника, с которым можно общаться асинхронно — прямо в трекере или в пулл-реквестах, как с обычным живым коллегой.
Жизненный цикл одной задачи
Самое ценное в автономном агенте — возможность вызывать его прямо из тех инструментов, которыми вы и так пользуетесь. Точкой входа может выступать, например, обычный тикет. Вы не идёте в отдельный интерфейс, а просто пишете в комментариях к задаче команду: @robot-agent /solve <добавь новый экран>.
Дальше запускается цепочка действий:
-
Срабатывает триггер webhook на ваш комментарий и передаёт задачу в оркестратор.
-
Оркестратор проверяет доступы и поднимает изолированное окружение на один запуск — например, Docker-контейнер. Это нужно для безопасности, чтобы агент случайно не удалил нужные данные и не получил доступ к лишним секретам.
-
В эту чистую среду подтягиваются ключи, общие правила проекта и локальные скиллы.
-
Агент читает тикет, строит план, пишет код, проверяет его через субагентов и даже открывает собранную страницу в браузере.
-
Результат возвращается обратно в трекер, и агент самостоятельно приносит готовый Pull Request.
Вы приходите на ревью и проверяете написанный код. Если нужно внести правки, вы просто оставляете комментарии и пишете: @robot-agent /fix-review. Агент пройдёт по вашим замечаниям и внесёт точечные исправления.
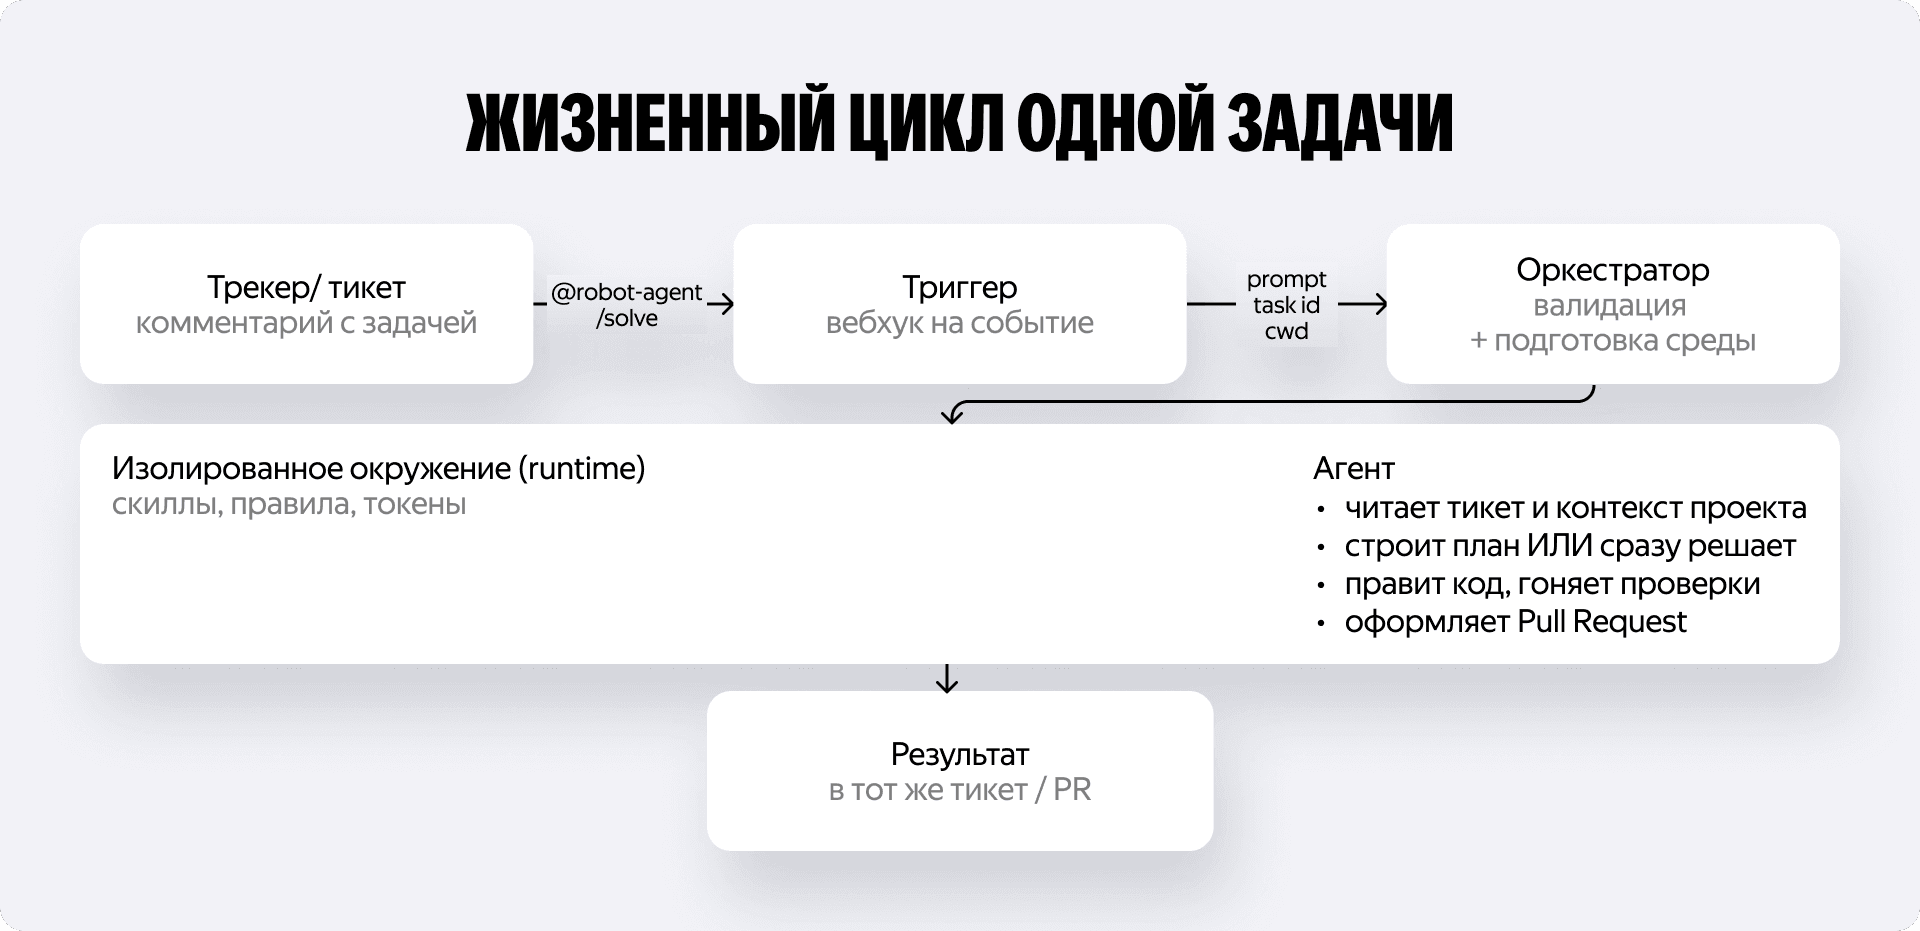
Главный вывод из всего этого опыта простой: автономный пайплайн — это не одна большая умная языковая модель. Это выверенная связка из безопасного изолированного окружения, чётких скиллов, удобной точки входа и оркестратора, который склеивает всё это воедино. Именно тогда типовая задача превращается в удобный асинхронный процесс, который не требует вашего постоянного участия.
Финал
После того как мы выстроили мощный автономный пайплайн, может возникнуть соблазн делегировать нейросети вообще всю работу. Особенно во время учёбы или стажировки, когда вокруг так много всего интересного, а дедлайны горят.
Но здесь важно понимать одну вещь, о которой отлично написал Эдди Османи в статье «Don't outsource your learning». Учёба — это навык, который строится исключительно вашей собственной головой. Вы не можете аутсорсить этот процесс. Когда вы решаете задачу сами, спотыкаетесь, злитесь, долго гуглите проблему и наконец получаете работающий код, вы реально растёте. В этот момент в вашей голове достраиваются нужные нейронные связи. А если домашнее задание за вас решает ИИ-агент, новые навыки с вами надолго не останутся.
Поэтому я советую использовать ИИ не как кнопку «решить задачу за две секунды», а как персонального репетитора, ассистента, наставника. Он доступен круглосуточно и никогда не устаёт от ваших вопросов. Изучаете рекурсию — напишите код руками, даже если с первого раза не выходит. Разбираетесь с алгоритмами — прорешивайте их самостоятельно. А всё, что не является предметом изучения прямо сейчас, смело отдавайте нейросети. Попросите её объяснить непонятную ошибку в консоли, накидать десять дополнительных задач на закрепление темы или собрать краткий конспект по длинной лекции.
То же самое касается и собеседований. Да, индустрия меняется. У нас в Яндексе уже идут эксперименты, где мы целенаправленно проверяем навыки работы с ИИ-инструментами. Кандидату дают незнакомый проект, разрешают пользоваться любыми агентами и просят добавить небольшую фичу. Но это пока только эксперименты. На обычных классических секциях мы всё ещё ждём, что вы будете думать своей головой. Кандидаты, которые пытаются незаметно использовать модели во время интервью, попадаются нам всё чаще. Их участь обычно незавидна, поэтому лучше опирайтесь на собственные знания, а не на подсказки бота.
ИИ не заменяет инженера
Я начал эту статью с того, что автоматизировал свою рабочую рутину. И в этом кроется главная ценность всех чатов, MCP-серверов и автономных пайплайнов.
Нейросеть не заменяет инженера. Она усиливает подготовленного инженера.
Роботы нужны для того, чтобы забрать у нас скучные типовые задачи. Мы слой за слоем убираем необходимость писать шаблонный код, чтобы у нас осталось время на проектирование архитектуры, брейншторм требований и развитие продукта.
Дерзайте и вы. Пробуйте автоматизировать процессы вокруг себя и реализуйте собственные идеи. Сегодня у нас в руках есть инструменты, о которых всего четыре года назад мы могли только мечтать. Учитесь с невероятной скоростью и стройте классные продукты.